Un plan de site HTML liste l’ensemble des pages accessibles sur un site web. Il s’adresse aux visiteurs, pas aux robots d’indexation. Son rôle diffère donc d’un sitemap XML, que Google considère comme un signal de découverte sans garantie d’exploration ni d’indexation. La question qui se pose : entre un plan de site pensé pour les humains et une navigation classique par menus, lequel permet réellement de localiser plus vite une information précise ?
Plan de site HTML et sitemap XML : deux outils, deux fonctions distinctes
La confusion entre ces deux formats reste fréquente. Leurs objectifs, leurs destinataires et leurs limites ne se recoupent pas.
| Critère | Plan de site HTML | Sitemap XML |
|---|---|---|
| Destinataire principal | Visiteurs humains | Robots des moteurs de recherche |
| Format | Page web navigable avec liens cliquables | Fichier structuré listé dans le code |
| Objectif | Orienter un visiteur perdu vers la bonne page | Signaler aux moteurs l’existence d’URL à explorer |
| Garantie de résultat | Dépend de la clarté du classement et des intitulés | Aucune garantie d’indexation, même si l’URL est déclarée |
| Diagnostic possible | Test utilisateur direct (temps de recherche, taux de succès) | Suivi des écarts de couverture dans Search Console |
Un sitemap XML facilite la découverte de pages par les moteurs, mais une page listée peut rester non indexée si elle est bloquée, dupliquée ou jugée insuffisante. Le plan de site HTML, lui, ne résout rien côté SEO technique. Il sert un besoin de navigation humaine que les menus ne couvrent pas toujours.
Pour observer la mise en pratique d’un plan de site structuré par rubriques, le plan du site Claravox illustre une organisation thématique où chaque section renvoie vers des contenus regroupés par catégorie.
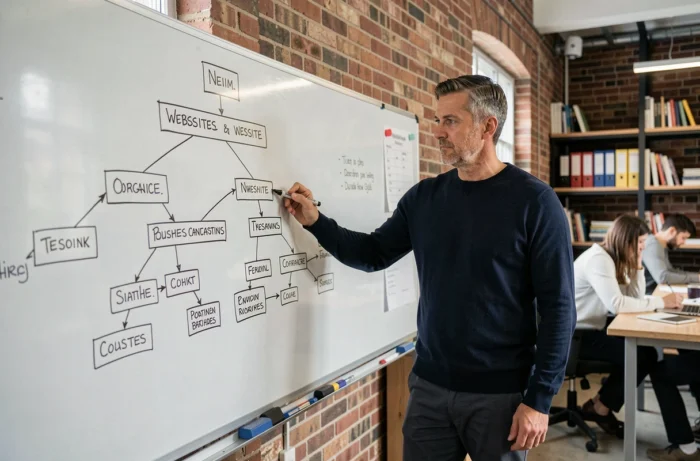
Architecture d’un plan de site HTML qui réduit le temps de recherche
Un plan de site ne remplace pas une navigation claire. Il la complète. Son utilité dépend de ce que la navigation existante permet déjà de trouver. Si un visiteur accède à toutes les pages depuis le menu principal en deux clics, le plan de site n’ajoute rien.
En revanche, dès qu’un site dépasse quelques dizaines de pages, des contenus finissent enfouis. Articles anciens, pages de service peu maillées, sous-catégories profondes : le plan de site expose ce que les menus masquent.
Regroupement par intention plutôt que par arborescence technique
L’erreur la plus courante consiste à reproduire l’arborescence technique du site (dossiers, sous-dossiers) dans le plan de site HTML. Un visiteur qui ne connaît pas l’organisation interne ne tire aucun bénéfice d’une liste classée par slug d’URL.
Regrouper les liens par thématique ou par besoin utilisateur change la donne. Un site de services peut classer ses pages par type de demande (devis, suivi, documentation) plutôt que par département interne.
- Chaque rubrique porte un intitulé explicite qui décrit le contenu, pas le nom du répertoire serveur
- Les pages les plus consultées apparaissent en haut de chaque rubrique, pas noyées dans l’ordre alphabétique
- Les liens morts ou les redirections en chaîne sont supprimés du plan : un lien qui mène à une erreur 404 dégrade la confiance du visiteur
Nombre de liens et lisibilité
Un plan de site qui affiche plusieurs centaines de liens sans hiérarchie visuelle perd son utilité. L’objectif est la scannabilité, pas l’exhaustivité. Limiter chaque rubrique à une vingtaine de liens, puis proposer un lien « voir tous les articles de cette catégorie » préserve la lisibilité.
Tests utilisateurs pour mesurer l’efficacité réelle du plan de site
Concevoir un plan de site en se fiant à sa propre logique d’organisation mène souvent à un outil qui fonctionne pour l’équipe interne et personne d’autre. Seul un test avec des utilisateurs externes révèle les angles morts.
Protocole de test rapide applicable sans budget
Recruter cinq personnes qui ne connaissent pas le site suffit pour détecter la majorité des problèmes de repérage. Le principe : donner une tâche précise (« trouvez la page qui explique les conditions de retour ») et chronométrer.
- Mesurer le temps entre l’arrivée sur le plan de site et le clic vers la bonne page
- Noter si le participant hésite entre deux rubriques (signe d’intitulés ambigus)
- Comparer le parcours via le plan de site au parcours via le menu principal : si le menu est plus rapide, le plan de site a un problème de conception
- Observer si le participant utilise la fonction de recherche du navigateur (Ctrl+F) sur le plan de site, ce qui signale un manque de structure visuelle
Après cinq sessions, les intitulés qui posent problème ressortent de manière récurrente. Renommer une rubrique ou déplacer un lien prend quelques minutes, et le gain de temps pour les visiteurs suivants est immédiat.
Ce que les tests révèlent sur le maillage interne
Les liens internes restent une voie de découverte complémentaire au plan de site, pas une solution universelle. Quand un testeur échoue à trouver une page depuis le plan de site, la question suivante est : cette page est-elle accessible par un autre chemin ? Si la réponse est non, le problème dépasse le plan de site et touche l’architecture de maillage interne du site entier.
Pour les sites volumineux, séparer les sitemaps XML par rubrique (produits, articles, services) permet de repérer les écarts de couverture par section dans Search Console. Ce diagnostic analytique complète les tests utilisateurs en identifiant les pages orphelines côté moteurs.
Plan de site et référencement naturel : complémentarité, pas substitution
Un plan de site HTML bien structuré distribue du maillage interne vers des pages profondes. Cette distribution aide les moteurs à découvrir des contenus peu liés depuis le reste du site. Mais il faut distinguer trois étapes que beaucoup confondent : découverte, exploration et indexation ne sont pas la même chose.
Une page peut être découverte via le plan de site, explorée par le robot, puis écartée de l’index parce que son contenu est trop similaire à une autre page. Le plan de site ne corrige pas un problème de contenu dupliqué ou de qualité insuffisante.
L’apport mesurable d’un plan de site HTML reste du côté utilisateur : un visiteur qui trouve la bonne page en moins de dix secondes au lieu de quitter le site. C’est cette réduction du taux de rebond, observable dans les données analytics, qui constitue le vrai signal de réussite d’un plan de site pensé pour les humains.